Servidor lento: comprender las causas y optimizarlo para recuperar el rendimiento
Un servidor lento nunca es lento “sin razón”: a menudo carece de recursos, procesa demasiadas solicitudes al mismo tiempo, o se bloquea por un cuello de botella en la aplicación, la base de datos o el disco. En la práctica, el buen método consiste en diagnosticar antes de actuar, de lo contrario solo se enmascaran los síntomas.
El objetivo de esta guía es simple: ayudarte a identificar la verdadera causa, distinguir lo que corresponde al servidor, la red o el código, y luego aplicar las correcciones más efectivas, en el orden correcto. Como guinda del pastel: evitarás las “falsas buenas ideas” que hacen perder tiempo, como reiniciar a ciegas o añadir recursos sin medir el efecto real.
En resumen
⚡ Un servidor lento suele deberse a un trío clásico: CPU saturado, memoria insuficiente o disco bajo presión.
🔍 El buen reflejo: medir primero el tiempo de respuesta del servidor, luego aislar el cuello de botella en lugar de hacer arreglos al azar.
🧩 Una base de datos lenta o un cache del servidor mal configurado puede afectar a una máquina que en teoría es correcta.
🚀 Las optimizaciones más rentables suelen ser simples: limpiar, limitar procesos innecesarios, corregir consultas pesadas y monitorizar a largo plazo.
¿Cómo reconocer que un servidor es realmente lento?
La respuesta corta: un servidor es realmente lento cuando sus tiempos de respuesta aumentan, las solicitudes se acumulan y la degradación se repite, incluso en pruebas simples. Antes de hablar de optimización, hay que verificar que la lentitud proviene de la infraestructura, y no de un navegador, una red externa o un pico temporal en la aplicación.
Los síntomas más frecuentes
En los hechos, las señales de alerta no siempre son espectaculares. Se ven principalmente retrasos que se alargan progresivamente, luego bloqueos puntuales. Por eso es útil seguir indicadores concretos en lugar de fiarse de una impresión general.
- Tiempo de respuesta elevado en páginas, APIs o servicios.
- Solicitudes que se acumulan en las colas de espera.
- Desconexiones, errores 502/504 o tiempos de espera intermitentes.
- Ralentización en ciertas horas, a menudo durante picos de tráfico.
- Carga de CPU o RAM que se mantiene alta durante períodos prolongados.
Distinguir servidor, red y aplicación
Es importante notar que una lentitud no significa automáticamente que la máquina esté mal dimensionada. Una red inestable, una consulta SQL demasiado costosa o una caché ausente pueden dar exactamente la misma sensación para el usuario. De ahí la importancia de un diagnóstico estructurado de servidor lento.
| Síntoma observado | Causa probable | Primer control | Acción rápida |
|---|---|---|---|
| Carga globalmente lenta | CPU, RAM o disco saturados | Uso de recursos del sistema | Aliviar la carga, detener procesos innecesarios |
| Páginas que responden y luego se bloquean | Base de datos lenta o cola de espera de la aplicación | Consultas lentas, registros de la aplicación | Optimizar consultas, activar caché |
| Ralentizaciones irregulares | Pico de tráfico o saturación temporal | Horas punta, número de conexiones | Limitar la concurrencia, monitorizar el aumento de carga |
| Tiempo de respuesta inestable | Red o alojamiento subdimensionado | Latencia, pérdidas, disponibilidad | Verificar el enlace de red y la capacidad de alojamiento |
Un servidor no es “lento por naturaleza”: se vuelve lento cuando un solo componente frena todo lo demás.
Las causas principales de un servidor lento
Una vez identificados los síntomas, es necesario remontar a la causa raíz. En la mayoría de los casos, la falla de rendimiento proviene de un recurso saturado, una configuración inestable o un procesamiento de la aplicación demasiado pesado. En otras palabras, la máquina puede estar sana, pero mal utilizada.
Recursos insuficientes
El trío clásico es CPU, memoria RAM y almacenamiento. Un procesador saturado alarga las colas de espera, una RAM demasiado baja impulsa el intercambio con el disco, y un almacenamiento lento o casi lleno ralentiza todo el sistema. Esto significa que el problema puede venir del eslabón más simple, no necesariamente del más visible.
- CPU saturada: demasiados cálculos simultáneos, compresión, procesamiento de imágenes, scripts pesados.
- Memoria insuficiente: intercambio frecuente, procesos que compiten entre sí.
- Disco demasiado lento o casi lleno: E/S en espera, registros voluminosos, base de datos limitada.
Problemas de configuración o de carga
Un servidor también puede volverse lento porque ejecuta demasiados servicios, con parámetros mal ajustados. Esto es frecuente después de una actualización, la adición de un módulo o una evolución del tráfico. En este caso, el sistema no está “roto”, simplemente está congestionado.
Cuellos de botella en la aplicación
Las consultas ineficaces a la base de datos a menudo causan más daños que una pequeña caída en el rendimiento del hardware. Sin índices, sin caché o con procesos en segundo plano demasiado pesados, la aplicación consume recursos inútilmente. Aquí, optimizar un servidor también pasa por el código y los datos.
Reiniciar puede hacer que vuelva el aire, pero no corrige ni una consulta lenta, ni una caché mal diseñada, ni una base de datos mal indexada.
Factores externos
Finalmente, no hay que subestimar las causas externas: picos de tráfico, alojamiento subdimensionado, latencia de red, copias de seguridad que se ejecutan en el momento equivocado. Un servidor puede parecer “defectuoso” cuando simplemente está soportando una carga inusual. De ahí la importancia del monitoring del servidor para leer el contexto, no solo la falla.
¿Diagnosticar la lentitud paso a paso?
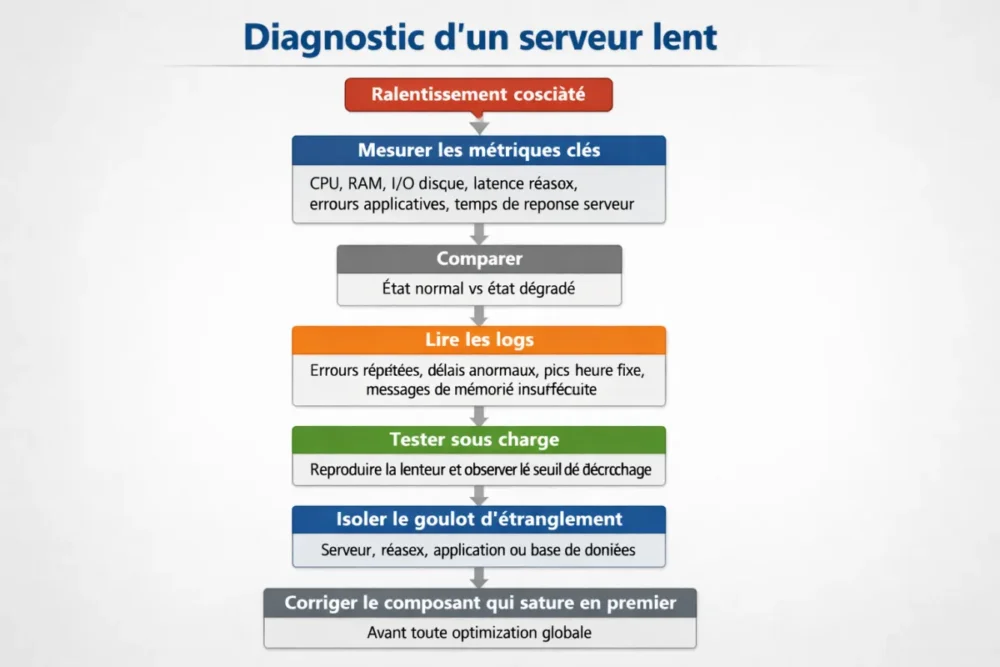
El mejor enfoque consiste en seguir una lógica simple: medir, comparar, aislar. Si intentas corregir sin jerarquizar los síntomas, corres el riesgo de perder tiempo y tocar en el lugar equivocado. Un buen diagnóstico de servidor lento comienza con algunas métricas estables, luego avanza hacia los registros y la carga real.
Medir las métricas correctas
Los indicadores prioritarios son conocidos: CPU, RAM, E/S de disco, latencia de red, errores de la aplicación y tiempo de respuesta del servidor. Si solo mides un punto, ves un síntoma. Si sigues varios en paralelo, comienzas a entender el mecanismo real.
- Registrar la carga del sistema en el momento de las ralentizaciones.
- Comparar el estado normal y el estado degradado.
- Identificar el componente que se satura primero.
- Verificar si la saturación es constante o está relacionada con un pico.
Leer los registros y detectar las anomalías
Los registros suelen ser más elocuentes de lo que se piensa. Errores repetidos, tiempos de respuesta anormales, picos de actividad a horas fijas, mensajes de memoria insuficiente: todo esto dibuja una trayectoria. En otras palabras, los registros no dan la solución final, pero orientan rápidamente hacia el nivel correcto de la pila.
Probar la carga y aislar el problema
Cuando es posible, hay que reproducir la lentitud en un entorno controlado. Probar bajo carga permite ver a partir de qué umbral el sistema falla. Esto es particularmente útil después de una actualización, un cambio de configuración o un aumento brusco del tráfico.
¿Cómo optimizar un servidor lento rápidamente?
La respuesta corta: comienza por las acciones reversibles, medibles y de alto impacto. La idea no es reescribir todo, sino eliminar los obstáculos más evidentes. Un servidor lento a menudo puede recuperar mucha fluidez con algunas correcciones bien dirigidas, siempre que se mantenga un ojo en las métricas después de cada cambio.
Acciones inmediatas de alto impacto
Antes de tocar la arquitectura, atiende las urgencias. Una saturación del disco, una cola de procesos innecesaria o una caché defectuosa pueden crear un efecto dominó. Las correcciones más efectivas suelen ser las más simples, siempre que se hagan correctamente.
- Liberar los recursos innecesarios: procesos zombies, servicios superfluos, tareas duplicadas.
- Resolver la saturación del disco: limpiar, archivar, mover los archivos grandes.
- Reducir la presión de la memoria: aligerar los servicios, verificar fugas, limitar los picos.
- Mejorar la caché del servidor: reducir los recálculos y las lecturas repetitivas.
Optimizar la base de datos y la aplicación
Cuando la base de datos se ralentiza, todo lo demás sigue. La optimización pasa entonces por consultas más limpias, índices pertinentes y la eliminación de llamadas innecesarias. Siempre es recomendable probar cada modificación en un entorno no crítico antes de generalizarla: así se evita reemplazar un problema por otro.
- Reducir las consultas costosas y las uniones innecesarias.
- Crear o corregir los índices en las columnas realmente filtradas.
- Limitar las llamadas repetitivas en los bucles o en las páginas muy solicitadas.
- Limpiar los procesos en segundo plano que consumen demasiados recursos.
Ajustar la configuración del sistema
Un servidor mal configurado puede perder mucho rendimiento sin estar “lleno”. Entonces hay que revisar los límites de conexiones, los parámetros de los servicios, la concurrencia permitida y las tareas programadas. Aquí, la regla de oro es simple: modificar una cosa a la vez y luego medir el efecto. Sin medición, no hay diagnóstico real.
Optimizaciones duraderas para evitar que la lentitud regrese
Una buena optimización no sirve de nada si la lentitud vuelve dos días después. Para mantenerla a largo plazo, hay que vigilar, documentar y estandarizar. Es menos atractivo que una corrección rápida, pero infinitamente más rentable a largo plazo.
Implementar un monitoreo continuo
El monitoreo del servidor permite seguir las tendencias antes de la caída del rendimiento. Manteniendo un historial de recursos, tiempos de respuesta y errores, detectas las desviaciones antes de que sean visibles para los usuarios. Es la mejor manera de anticiparse en lugar de sufrir.
Dimensionar correctamente la infraestructura
Llega un momento en que la optimización del software alcanza sus límites. Si el tráfico aumenta regularmente, si el disco sigue saturado a pesar de la limpieza o si la CPU está al máximo continuamente, hay que considerar una mejora de capacidad. Esto puede implicar más memoria, un almacenamiento más rápido o una arquitectura mejor distribuida.
Estandarizar el mantenimiento
A los servidores les gusta la regularidad. Actualizaciones controladas, limpieza periódica, verificación de logs, pruebas después de cada modificación: estos gestos evitan sorpresas desagradables. En la práctica, un pequeño ritual de mantenimiento vale más que una gran intervención cada seis meses.
¿Cuándo hay que considerar una mejora de capacidad?
La respuesta correcta: cuando la saturación vuelve a pesar de correcciones serias, y las métricas muestran un límite de hardware o estructural. Si el servidor es lento porque es permanentemente demasiado pequeño para su carga, la optimización sola no bastará. Entonces hay que decidir entre costo, riesgo y ganancia esperada.
Señales de que la optimización del software ya no es suficiente
Algunas señales son muy claras: saturación repetida, aumento regular del tráfico, colas que crecen incluso después de la optimización, o hardware al límite. En ese caso, es mejor invertir en una evolución coherente que multiplicar los parches.
Elegir entre optimización y actualización
La elección correcta depende de tres cosas: el costo de la corrección, la ganancia de rendimiento esperada y el nivel de riesgo aceptable. Si una optimización resuelve el 80 % del problema con un esfuerzo bajo, se prioriza sobre la actualización. Si el límite es estructural, simplemente hay que cambiar de escala.
Errores a evitar
Las malas prácticas suelen ser las mismas: confundir el síntoma con la causa, modificar varios parámetros a la vez, ignorar los registros o añadir servicios sin necesidad real. La trampa es creer que una acción rápida es necesariamente una buena acción. No siempre, ni mucho menos.
- No diagnosticar antes de corregir.
- No reiniciar sistemáticamente sin entender el origen de la lentitud.
- No multiplicar los servicios innecesarios que consumen CPU y RAM.
- No descuidar el monitoring después del cambio.
- No aplicar optimización sin medición antes/después.
A tener en cuenta
🧭 Un servidor lento se trata mejor con un método que con suposiciones.
🔧 La prioridad es el cuello de botella real, no el síntoma más visible.
📊 Las métricas clave siguen siendo CPU, RAM, I/O de disco y tiempo de respuesta del servidor.
🗃️ Una base de datos lenta o un cache del servidor mal configurado puede ralentizar todo.
🚦 El monitoring del servidor evita revivir la misma caída de rendimiento.
Preguntas frecuentes
¿Por qué mi servidor se vuelve lento de repente?
Una ralentización repentina suele indicar una saturación brusca, una actualización problemática, una tarea programada pesada o un problema en la base de datos. Hay que revisar los registros, la carga del sistema y los picos de tráfico en el período exacto del problema. Sin esta correlación, se navega a ciegas.
¿Cómo saber si el problema viene del CPU, la RAM o el disco?
Lo más sencillo es observar qué indicador sube primero en el momento en que aparece la lentitud. Un CPU muy alto ralentiza el cálculo, una RAM insuficiente provoca swap, y un disco lento se detecta por una fuerte espera de I/O. Los tres también pueden combinarse.
¿Hay que reiniciar un servidor lento?
Sólo si el diagnóstico lo justifica. Un reinicio puede aliviar temporalmente una saturación, pero no corrige la causa. Si no sabes por qué el servidor se ralentiza, es mejor primero recopilar las métricas y los registros, y luego actuar sobre el problema real.
¿Puede el cache realmente acelerar un servidor?
Sí, a menudo mucho. Un buen cache del servidor evita recalcular o releer constantemente los mismos datos, lo que reduce la carga en la base de datos y en el procesador. Pero un cache mal configurado también puede crear incoherencias o enmascarar otro problema.
¿Cuándo hay que aumentar los recursos del servidor?
Cuando las optimizaciones ya están en marcha, pero la saturación vuelve de forma constante. Si el tráfico aumenta y los recursos llegan a su límite a pesar de un buen tuning, la actualización se vuelve más racional que una serie de microcorrecciones. Lo importante es medir la ganancia esperada antes de decidir.