Google explore sans indexer une page lorsque Googlebot a visité son URL, mais ne l’a pas retenue dans son index. Ce statut ne signale pas automatiquement une pénalité. Il faut d’abord vérifier que la page doit réellement apparaître dans Google, puis contrôler son contenu, sa canonique, ses directives techniques, son maillage interne et son accessibilité.
Une page peut être techniquement accessible tout en étant jugée trop proche d’une autre URL, peu utile ou insuffisamment prioritaire. L’outil d’inspection d’adresse de Google Search Console permet de distinguer ces cas, mais une demande d’indexation ne garantit jamais l’ajout de la page dans les résultats.
En bref
- 🔎 « Explorée, actuellement non indexée » signifie que Google a consulté l’URL sans la conserver dans son index.
- 🧭 Vérifiez d’abord l’objectif de la page, puis la canonique, la balise noindex, le fichier robots.txt, le code HTTP et le contenu.
- 🧩 Une page utile doit être distincte, accessible, reliée par des liens internes et cohérente avec le plan de site XML.
- ⏳ La demande d’indexation Google relance une sollicitation d’exploration. Elle ne constitue pas une promesse d’indexation ni de positionnement.
Page explorée, actuellement non indexée : ce que ce statut signifie vraiment
Le statut indique une visite de Googlebot, pas une validation éditoriale. Google a pu récupérer l’URL et analyser son contenu, mais l’URL n’a pas été ajoutée à l’index au moment du contrôle. L’exploration et l’indexation sont deux décisions différentes.
Google a visité la page, mais ne l’a pas nécessairement retenue
La détection correspond au moment où Google connaît une URL, par exemple grâce à un lien ou à un plan de site XML. L’exploration intervient lorsque Googlebot demande la page au serveur. L’indexation correspond ensuite à la sélection de cette page dans la base de résultats. Le positionnement arrive encore après : une page indexée peut rester très difficile à trouver pour une requête donnée.
Le message « Page explorée, actuellement non indexée » ne fournit pas, à lui seul, la cause exacte. Il peut accompagner une page accessible avec un contenu redondant, une canonique différente, une faible priorité interne ou une valeur éditoriale insuffisamment distinctive. La documentation de Google Search Central présente l’indexation comme un processus non garanti, y compris après exploration.
Une page non indexée n’est pas forcément un problème
Une URL de filtre, de tri, de recherche interne, de test ou d’espace privé n’a généralement pas vocation à attirer une visite depuis Google. Une fiche produit retirée, une variante presque identique ou une page temporaire peut aussi être volontairement écartée. La première décision consiste donc à répondre clairement à cette question : l’URL sert-elle une recherche identifiable et un objectif réel du site ?
La croyance « toute page publiée doit être indexée » est fausse. Un site cohérent peut contenir des URL accessibles mais exclues, tandis qu’une page stratégique mérite une correction approfondie plutôt qu’une simple relance dans Search Console.
Diagnostiquer l’URL avant toute correction
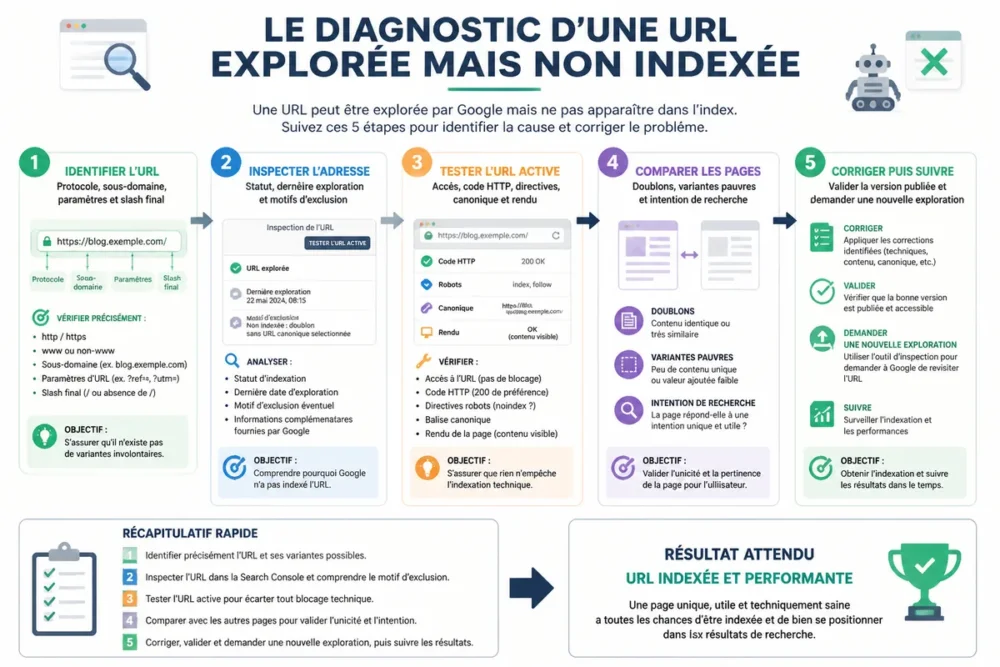
Commencez par l’adresse exacte : protocole, sous-domaine, paramètres et slash final peuvent désigner des URL différentes. L’outil d’inspection d’adresse de Google Search Console compare l’état connu de l’URL avec le résultat d’un test sur la version actuellement accessible.
Lire les informations utiles dans l’outil d’inspection d’adresse
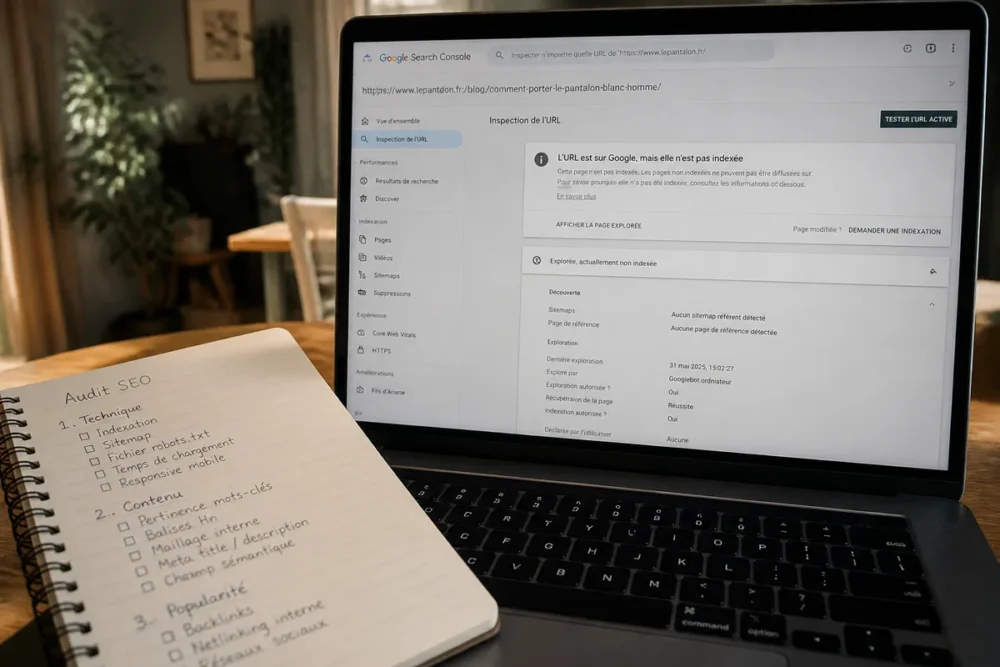
Inspectez l’URL problématique dans Search Console, puis relevez le statut de couverture, la date de dernière exploration, l’URL canonique déclarée et la canonique sélectionnée par Google lorsqu’elle est affichée. Comparez également les résultats du test de l’URL active avec la version déjà connue par Google.
Une différence entre la canonique déclarée et la canonique sélectionnée constitue un signal important, mais pas une preuve automatique de mauvaise configuration. La page choisie par Google peut être considérée comme une version plus représentative lorsque plusieurs URL répondent au même besoin.
Contrôler les signaux techniques fondamentaux
Vérifiez le code HTTP final. Une page destinée à l’indexation doit normalement être accessible publiquement et renvoyer une réponse stable, sans boucle de redirection ni erreur serveur persistante. Contrôlez ensuite la balise meta robots, l’en-tête HTTP X-Robots-Tag, la balise canonique, les règles de robots.txt et la présence de l’URL finale dans le plan de site XML.
Le fichier robots.txt mérite une attention particulière : il peut empêcher l’exploration d’une ressource, mais il ne remplace pas une directive noindex. Une URL bloquée à l’exploration peut donc rester connue de Google sans que son contenu puisse être correctement évalué.
Évaluer la page comme le ferait un moteur et un lecteur
Ouvrez la page sans session connectée et vérifiez que le contenu principal apparaît réellement. Un rendu JavaScript incomplet, une erreur de chargement ou un contenu visible uniquement après une interaction peuvent réduire la compréhension de l’URL.
Comparez la page avec les URL proches du site : fiches produits similaires, pages locales, catégories, articles traitant la même intention ou variantes à paramètres. Une page ancienne peut aussi disparaître de l’index si son contenu devient obsolète, si une autre URL la remplace ou si sa valeur relative diminue après une refonte.
-
Relever l’adresse exacte
Copiez l’URL telle qu’elle est publiée et notez ses paramètres éventuels.
-
Inspecter dans Search Console
Comparez le statut connu, la canonique et la date d’exploration avec le test de l’URL active.
-
Contrôler l’indexabilité
Vérifiez le code HTTP, les redirections, noindex, X-Robots-Tag, robots.txt et le rendu.
-
Comparer les contenus
Identifiez les doublons, les variantes faibles et les pages qui ciblent déjà la même intention.
-
Corriger puis suivre
Ne demandez une nouvelle exploration qu’après validation de la version publiée.
Les causes les plus fréquentes d’une page explorée mais non indexée
Une page explorée mais non indexée n’a pas une cause unique. Le diagnostic doit séparer les exclusions volontaires, les contradictions techniques, la duplication et la faible priorité éditoriale afin d’éviter une correction inadaptée.
| Symptôme observé | Vérification | Action adaptée | Erreur à éviter |
|---|---|---|---|
| Directive noindex | Code source et en-tête HTTP | Retirer la directive si la page doit être indexée | La supprimer sans vérifier le rôle de l’URL |
| Canonique différente | Balise canonique et URL sélectionnée | Aligner la canonique avec la page de référence | Déclarer une canonique contradictoire avec le maillage |
| Contenu très proche | Comparaison avec les pages voisines | Différencier, fusionner ou hiérarchiser les URL | Ajouter du texte générique sans valeur nouvelle |
| Page orpheline | Liens internes et parcours de navigation | Créer des liens contextuels depuis des pages pertinentes | Créer artificiellement des liens sans rapport |
| Accès ou rendu instable | Code HTTP, serveur et test de l’URL active | Corriger l’accès et le chargement du contenu principal | Relancer l’indexation avant de stabiliser la page |
Une directive ou une configuration exclut l’URL
Une balise noindex peut provenir d’un modèle, d’un réglage de système de gestion de contenu ou d’un outil SEO. Une canonique pointant vers une autre page, une redirection mal configurée, une erreur serveur ou une règle d’accès peuvent également modifier le traitement de l’URL.
Le plan de site XML n’annule aucune de ces directives. Un sitemap aide Google à connaître les URL que le site considère comme importantes, mais il ne force ni l’exploration ni l’indexation.
Google privilégie une autre page très proche
Les doublons ne sont pas limités aux copies strictes. Deux fiches avec une description presque identique, des pages locales différenciées par un seul nom de ville ou des URL de filtres peuvent répondre au même besoin avec trop peu de différence utile. Google peut alors retenir une autre version comme référence.
La décision doit être éditoriale avant d’être technique : conservez deux pages si leurs publics, informations et intentions diffèrent réellement ; fusionnez-les si leur coexistence disperse la même réponse. Une redirection ne doit être posée qu’après vérification de la valeur de l’ancienne URL pour les utilisateurs et les liens existants.
La page manque de valeur éditoriale ou de signaux de priorité
Une page courte n’est pas automatiquement mauvaise. Le problème apparaît lorsqu’elle répond de façon incomplète, interchangeable ou moins précise qu’une autre page déjà présente sur le site. Une page stratégique doit apporter une réponse identifiable, des informations vérifiables, un angle propre et une expérience de lecture suffisante pour son intention.
Une page orpheline, rarement reliée ou publiée dans une section peu accessible reçoit aussi moins de signaux internes de priorité. Les liens externes peuvent aider à la découverte et à la crédibilité, mais leur absence ne prouve pas à elle seule la cause de la non-indexation.
Corriger selon la cause, sans chercher à forcer l’indexation
La bonne correction est celle qui supprime la contradiction détectée. Retirer un noindex, réécrire une page ou ajouter un lien interne sans diagnostic peut déplacer le problème au lieu de le résoudre. Une URL stratégique doit être utile, indexable, canonique et reliée au site.
Corriger un blocage technique involontaire
Retirez la directive noindex uniquement si l’URL doit être visible dans les moteurs. Alignez ensuite la balise canonique, les liens internes, le plan de site XML et les redirections sur la même URL finale. Contrôlez le code source et le test de l’URL active après publication.
Une erreur d’accès doit être traitée côté serveur ou application. Le contenu principal doit être récupérable sans connexion et sans dépendre d’un chargement instable. Une demande d’indexation avant cette validation n’apporte pas de solution durable.
Renforcer une page utile mais insuffisamment distinctive
Réécrivez autour de l’intention réelle plutôt que d’allonger mécaniquement le texte. Ajoutez les informations qui manquent : procédure, critères, limites, exemples, données datées ou sources nommées. Les éléments d’expertise doivent être vérifiables ; une page ne gagne pas en fiabilité par l’ajout de formulations promotionnelles.
Pour un site éditorial, l’analyse d’une page déjà indexée peut compléter ce contrôle, à condition de comparer des URL visant une intention proche. Pour une page commerciale ou locale, différenciez les données réellement propres à l’offre, au lieu de remplacer seulement quelques mots-clés.
Améliorer le maillage et traiter les doublons
Ajoutez des liens internes contextuels depuis des pages importantes et pertinentes : une catégorie vers une fiche, un article vers une méthode détaillée ou une page de service vers une zone réellement couverte. L’ancre doit décrire la destination et le lien doit aider le parcours, pas seulement transmettre un signal.
Retirez du sitemap les URL redirigées, exclues ou non canoniques. Maintenez l’URL finale que le site souhaite voir explorée. Lorsque deux pages répondent au même besoin, fusionner peut être plus propre que maintenir deux contenus faibles.
Demander une nouvelle exploration et suivre l’évolution
La demande d’indexation Google se justifie après une correction significative sur une URL finale, accessible et réellement utile. La fonctionnalité peut évoluer dans Search Console ; vérifiez le libellé et les limites affichés dans l’interface au moment de l’utilisation.
Quand utiliser la demande d’indexation Google
Utilisez-la après la correction d’un noindex, d’une canonique, d’un problème d’accès ou d’une refonte éditoriale substantielle. La demande envoie une sollicitation à Google pour réexplorer l’URL ; elle ne réserve pas une place dans l’index et ne garantit aucun délai d’indexation Google.
Ne répétez pas la même demande en boucle. Dans ce cas, ne demandez pas l’indexation avant d’avoir corrigé la cause. Une page doublon ou sans intention propre restera à traiter sur le fond.
Quand attendre, améliorer ou revoir l’objectif de la page
Après une modification, laissez le temps à Google de revisiter la page et de réévaluer ses signaux. Aucun délai universel ne peut être annoncé sans connaître le site, son architecture, sa fréquence d’exploration et l’importance de l’URL.
Suivez le statut dans Search Console et comparez la date de dernière exploration. Si l’URL reste secondaire, similaire à une autre ou inutile pour une recherche identifiable, améliorez-la, fusionnez-la, redirigez-la ou laissez-la exclue selon son rôle. L’objectif est un index cohérent, pas un volume maximal d’URL.
Une méthode de suivi simple
Conservez pour chaque URL la date de correction, la nature du changement et le résultat observé. Cette trace évite de modifier plusieurs signaux simultanément sans savoir ce qui a changé. Un audit de logs peut compléter Search Console sur un site important, notamment pour vérifier les passages de Googlebot et les réponses serveur, mais il ne remplace pas l’analyse de contenu.
Les outils SEO ou les extensions WordPress peuvent faciliter le contrôle des balises, du sitemap et des liens. Ils ne disposent pas d’un moyen légitime pour garantir l’indexation ; leurs alertes doivent être confirmées sur la page publiée et dans la documentation officielle de Google.
Questions fréquentes sur Google qui explore sans indexer
Une page explorée mais non indexée est-elle pénalisée par Google ?
Non, ce statut ne prouve pas une pénalité. Il indique que Google a exploré l’URL sans la retenir dans son index à ce moment-là. Recherchez d’abord une directive technique, un doublon ou une valeur éditoriale insuffisamment distincte.
Le plan de site XML suffit-il à faire indexer une page ?
Non. Un plan de site XML signale les URL que le site juge importantes, mais il ne garantit ni l’exploration ni l’indexation. L’URL doit aussi être accessible, cohérente avec sa canonique, utile et correctement reliée au reste du site.
Combien de temps attendre après une demande d’indexation Google ?
Google ne fournit pas de délai universel applicable à toutes les pages. Surveillez la dernière exploration et le statut dans Search Console plutôt que de multiplier les demandes. Une absence de résultat doit conduire à réexaminer la page, pas seulement à relancer l’outil.
Faut-il supprimer une page que Google n’indexe pas ?
Non, pas automatiquement. Conservez et améliorez une page qui cible une intention propre ; fusionnez-la si une autre URL répond au même besoin ; excluez-la si elle sert un filtre, un test ou une fonction qui n’a pas vocation à apparaître dans Google.
Pourquoi une page ancienne peut-elle disparaître de l’index Google ?
Une page ancienne peut devenir moins utile, être remplacée par une autre URL, perdre sa cohérence technique ou ne plus répondre correctement à l’intention de recherche. Vérifiez les changements de contenu, de canonique, de liens internes, de redirections et d’accessibilité avant de conclure.
Peut-on demander plusieurs fois l’indexation de la même URL ?
Une nouvelle demande peut être faite après une correction substantielle, mais les répétitions identiques ne constituent pas une stratégie. Corrigez d’abord le problème identifié, validez la version publiée, puis utilisez la demande pour une URL finale réellement utile.
Une indexation durable se favorise en supprimant les contradictions techniques et en donnant à chaque URL une utilité claire, unique et bien reliée au reste du site. Lorsque le diagnostic ne permet pas de trancher, conservez les observations de Search Console, les réponses serveur et les versions du contenu avant toute modification supplémentaire.