Langsamer Server: Ursachen verstehen und optimieren, um die Leistung wiederherzustellen
Ein langsamer Server ist nie „ohne Grund“ langsam: Oft fehlen Ressourcen, es werden zu viele Anfragen gleichzeitig verarbeitet oder es gibt einen Engpass in der Anwendung, der Datenbank oder der Festplatte. In der Praxis besteht die richtige Methode darin, zuerst zu diagnostizieren und dann zu handeln, sonst werden nur die Symptome überdeckt.
Das Ziel dieses Leitfadens ist einfach: Dir zu helfen, die wahre Ursache zu identifizieren, zu unterscheiden, ob es am Server, Netzwerk oder Code liegt, und dann die effektivsten Korrekturen in der richtigen Reihenfolge anzuwenden. Das Sahnehäubchen: Du vermeidest „falsche gute Ideen“, die Zeit kosten, wie blindes Neustarten oder das Hinzufügen von Ressourcen ohne Messung der tatsächlichen Wirkung.
Kurz gesagt
⚡ Ein langsamer Server resultiert oft aus einem klassischen Trio: ausgelastete CPU, unzureichender Arbeitsspeicher oder unter Druck stehende Festplatte.
🔍 Die richtige Reaktion: Zuerst die Server-Antwortzeit messen, dann den Engpass isolieren, statt zufällig zu basteln.
🧩 Eine langsame Datenbank oder ein schlecht konfigurierter Server-Cache kann eine eigentlich solide Maschine ausbremsen.
🚀 Die rentabelsten Optimierungen sind oft einfach: Aufräumen, unnötige Prozesse begrenzen, schwere Anfragen korrigieren und langfristig überwachen.
Wie erkennt man, dass ein Server wirklich langsam ist?
Die kurze Antwort: Ein Server ist wirklich langsam, wenn seine Antwortzeiten steigen, Anfragen sich stapeln und die Verschlechterung sich wiederholt, selbst bei einfachen Tests. Bevor man von Optimierung spricht, muss man sicherstellen, dass die Langsamkeit wirklich von der Infrastruktur kommt und nicht vom Browser, einem externen Netzwerk oder einem temporären Anstieg auf der Anwendungsseite.
Die häufigsten Symptome
In der Praxis sind die Warnzeichen nicht immer spektakulär. Meist sieht man vor allem eine allmähliche Verlängerung der Wartezeiten und dann gelegentliche Blockaden. Deshalb ist es sinnvoll, konkrete Indikatoren zu verfolgen, statt sich auf einen allgemeinen Eindruck zu verlassen.
- Hohe Antwortzeiten auf Seiten, APIs oder Dienste.
- Anfragen, die sich in Warteschlangen ansammeln.
- Verbindungsabbrüche, Fehler 502/504 oder intermittierende Timeouts.
- Verlangsamungen zu bestimmten Zeiten, oft bei Verkehrsspitzen.
- CPU- oder RAM-Auslastung, die über längere Zeit hoch bleibt.
Server, Netzwerk und Anwendung unterscheiden
Es ist zu beachten, dass Langsamkeit nicht automatisch bedeutet, dass die Maschine falsch dimensioniert ist. Ein instabiles Netzwerk, eine zu teure SQL-Anfrage oder ein fehlender Cache können genau dasselbe Nutzererlebnis erzeugen. Daher ist eine strukturierte Diagnose bei einem langsamen Server sinnvoll.
| Beobachtetes Symptom | Wahrscheinliche Ursache | Erste Kontrolle | Schnelle Maßnahme |
|---|---|---|---|
| Allgemein langsames Laden | Ausgelastete CPU, RAM oder Festplatte | Systemressourcennutzung | Last reduzieren, unnötige Prozesse stoppen |
| Seiten reagieren und blockieren dann | Langsame Datenbank oder Anwendungs-Warteschlange | Langsame Anfragen, Anwendungs-Logs | Anfragen optimieren, Cache aktivieren |
| Unregelmäßige Verlangsamungen | Verkehrsspitze oder temporäre Auslastung | Stoßzeiten, Verbindungsanzahl | Konkurrenz begrenzen, Lastanstieg überwachen |
| Instabile Antwortzeiten | Unterdimensioniertes Netzwerk oder Hosting | Latenz, Verluste, Verfügbarkeit | Netzwerkverbindung und Hosting-Kapazität prüfen |
Ein Server ist nicht „von Natur aus langsam“: Er wird langsam, wenn eine einzige Komponente den Rest ausbremst.
Die Hauptursachen für einen langsamen Server
Sobald die Symptome erkannt sind, muss die Grundursache ermittelt werden. In den meisten Fällen liegt die Leistungsstörung an einer ausgelasteten Ressource, einer instabilen Konfiguration oder einer zu schweren Anwendungsbearbeitung. Anders gesagt, die Maschine kann gesund sein, aber schlecht genutzt werden.
Unzureichende Ressourcen
Das klassische Trio sind CPU, Arbeitsspeicher und Speicher. Ein ausgelasteter Prozessor verlängert die Warteschlangen, zu wenig RAM führt zum Auslagern auf die Festplatte, und ein langsamer oder fast voller Speicher verlangsamt das gesamte System. Das bedeutet, dass das Problem vom einfachsten Glied kommen kann, nicht unbedingt vom sichtbarsten.
- Ausgelastete CPU: zu viele gleichzeitige Berechnungen, Kompression, Bildverarbeitung, schwere Skripte.
- Unzureichender Arbeitsspeicher: häufiges Swapping, Prozesse, die sich gegenseitig Konkurrenz machen.
- Zu langsame oder fast volle Festplatte: wartende Ein-/Ausgaben, umfangreiche Logs, beengte Datenbank.
Konfigurations- oder Lastprobleme
Ein Server kann auch langsam werden, weil er zu viele Dienste mit schlecht angepassten Parametern ausführt. Das ist häufig nach einem Update, der Hinzufügung eines Moduls oder einer Verkehrsentwicklung der Fall. In diesem Fall ist das System nicht „kaputt“, es ist einfach überlastet.
Anwendungsbedingte Engpässe
Unwirksame Datenbankabfragen verursachen oft mehr Schaden als ein kleiner Leistungsabfall der Hardware. Ohne Index, ohne Cache oder mit zu schweren Hintergrundprozessen verbraucht die Anwendung Ressourcen umsonst. Hier bedeutet die Optimierung eines Servers auch die Optimierung von Code und Daten.
Ein Neustart kann frische Luft bringen, behebt aber weder eine langsame Abfrage, noch einen schlecht durchdachten Cache oder eine schlecht indexierte Datenbank.
Externe Faktoren
Schließlich sollte man externe Ursachen nicht unterschätzen: Verkehrsspitzen, unterdimensioniertes Hosting, Netzwerklatenz, Backups, die zur falschen Zeit laufen. Ein Server kann „ausfallend“ erscheinen, obwohl er nur eine ungewöhnliche Last trägt. Daher ist Server-Monitoring wichtig, um den Kontext zu verstehen, nicht nur den Ausfall.
Langsamkeit Schritt für Schritt diagnostizieren?
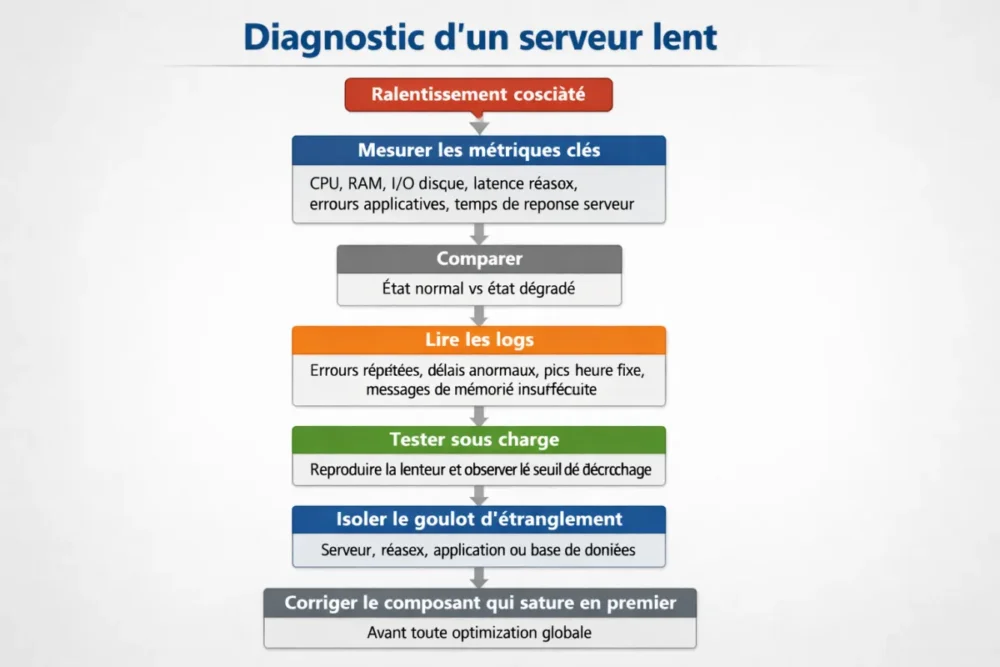
Der beste Ansatz besteht darin, einer einfachen Logik zu folgen: messen, vergleichen, isolieren. Wenn du versuchst, ohne Priorisierung der Symptome zu korrigieren, verlierst du Zeit und greifst an der falschen Stelle an. Eine gute Diagnose eines langsamen Servers beginnt mit einigen stabilen Metriken und geht dann zu Logs und der tatsächlichen Last über.
Die richtigen Metriken messen
Die wichtigsten Indikatoren sind bekannt: CPU, RAM, Festplatten-I/O, Netzwerklatenz, Anwendungsfehler und Server-Antwortzeit. Wenn du nur einen Punkt misst, siehst du ein Symptom. Wenn du mehrere parallel verfolgst, beginnst du, den tatsächlichen Mechanismus zu verstehen.
- Die Systemlast zum Zeitpunkt der Verlangsamungen erfassen.
- Den Normalzustand mit dem verschlechterten Zustand vergleichen.
- Die Komponente identifizieren, die zuerst ausgelastet ist.
- Überprüfen, ob die Auslastung konstant oder spitzenartig ist.
Logs lesen und Anomalien erkennen
Logs sind oft aussagekräftiger als man denkt. Wiederholte Fehler, anormale Antwortzeiten, Aktivitätsspitzen zu festen Zeiten, Meldungen über unzureichenden Speicher: all das zeichnet eine Spur. Anders gesagt, Logs liefern nicht die endgültige Lösung, weisen aber schnell auf die richtige Ebene des Stacks hin.
Last testen und Problem isolieren
Wenn möglich, sollte die Langsamkeit in einem kontrollierten Rahmen reproduziert werden. Belastungstests zeigen, ab welcher Schwelle das System versagt. Das ist besonders nützlich nach einem Update, einer Konfigurationsänderung oder einem plötzlichen Verkehrszuwachs.
Wie optimiert man einen langsamen Server schnell?
Die kurze Antwort: Beginne mit umkehrbaren, messbaren und wirkungsvollen Maßnahmen. Die Idee ist nicht, alles neu zu schreiben, sondern die offensichtlichsten Bremsen zu entfernen. Ein langsamer Server kann oft mit einigen gezielten Korrekturen viel flüssiger werden, vorausgesetzt, man behält nach jeder Änderung die Metriken im Auge.
Sofortige Maßnahmen mit großer Wirkung
Bevor du an der Architektur herumspielst, behebe die dringenden Probleme. Eine volle Festplatte, eine unnötige Prozesswarteschlange oder ein fehlerhafter Cache können eine Dominoeffekt auslösen. Die effektivsten Korrekturen sind oft die einfachsten, vorausgesetzt, sie werden ordentlich durchgeführt.
- Unnötige Ressourcen freigeben: Zombie-Prozesse, überflüssige Dienste, doppelte Aufgaben.
- Festplattenüberlastung beheben: große Dateien bereinigen, archivieren, verschieben.
- Speicherdruck reduzieren: Dienste entlasten, Lecks überprüfen, Spitzen begrenzen.
- Server-Cache verbessern: Neuberechnungen und wiederholte Lesezugriffe reduzieren.
Datenbank und Anwendung optimieren
Wenn die Datenbank langsamer wird, folgt alles andere. Die Optimierung erfolgt dann durch sauberere Abfragen, relevante Indizes und das Entfernen unnötiger Aufrufe. Es ist immer ratsam, jede Änderung in einer nicht-kritischen Umgebung zu testen, bevor man sie allgemein einführt: So vermeidet man, ein Problem durch ein anderes zu ersetzen.
- Teure Abfragen und unnötige Joins reduzieren.
- Indizes erstellen oder korrigieren auf den tatsächlich gefilterten Spalten.
- Wiederholte Aufrufe in Schleifen oder stark frequentierten Seiten begrenzen.
- Hintergrundprozesse bereinigen, die zu viele Ressourcen verbrauchen.
Systemkonfiguration anpassen
Ein schlecht eingestellter Server kann viel Leistung verlieren, ohne „voll“ zu sein. Dann müssen Verbindungsgrenzen, Dienstparameter, erlaubte Konkurrenz und geplante Aufgaben überprüft werden. Die goldene Regel hier ist einfach: Ändere immer nur eine Sache auf einmal und messe die Wirkung. Ohne Messung gibt es keine echte Diagnose.
Dauerhafte Optimierungen, um erneute Langsamkeit zu vermeiden
Eine gute Optimierung nützt nichts, wenn die Langsamkeit zwei Tage später zurückkehrt. Um langfristig stabil zu bleiben, muss man überwachen, dokumentieren und standardisieren. Das ist weniger aufregend als eine schnelle Korrektur, aber auf lange Sicht unendlich rentabler.
Kontinuierliches Monitoring einrichten
Server-Monitoring ermöglicht es, Trends vor einem Leistungsabfall zu erkennen. Indem man eine Historie der Ressourcen, Antwortzeiten und Fehler führt, entdeckt man Abweichungen, bevor sie für die Nutzer sichtbar werden. Das ist die beste Methode, um vorzubeugen statt zu reagieren.
Infrastruktur richtig dimensionieren
Irgenwann stößt die Softwareoptimierung an ihre Grenzen. Wenn der Traffic regelmäßig steigt, die Festplatte trotz Reinigung voll bleibt oder die CPU dauerhaft ausgelastet ist, muss man eine Skalierung in Betracht ziehen. Das kann mehr Speicher, schnelleren Speicher oder eine besser verteilte Architektur bedeuten.
Wartung standardisieren
Server mögen Regelmäßigkeit. Kontrollierte Updates, regelmäßige Reinigung, Protokollprüfung, Tests nach jeder Änderung: Diese Maßnahmen verhindern böse Überraschungen. In der Praxis ist ein kleines Wartungsritual besser als eine große Intervention alle sechs Monate.
Wann sollte man eine Skalierung in Betracht ziehen?
Die richtige Antwort: Wenn die Überlastung trotz ernsthafter Korrekturen zurückkehrt und die Metriken eine Hardware- oder Strukturgrenze zeigen. Wenn der Server langsam ist, weil er dauerhaft zu klein für seine Last ist, reicht Optimierung allein nicht aus. Dann muss man zwischen Kosten, Risiko und erwartetem Gewinn abwägen.
Zeichen, dass Softwareoptimierung nicht mehr ausreicht
Einige Signale sind sehr eindeutig: wiederholte Überlastung, stetig steigender Traffic, wachsende Warteschlangen trotz Optimierung oder erschöpfte Hardware. In diesem Fall ist es besser, in eine kohärente Weiterentwicklung zu investieren, als immer mehr Flickschusterei zu betreiben.
Wahl zwischen Optimierung und Upgrade
Die richtige Wahl hängt von drei Dingen ab: den Kosten der Behebung, dem erwarteten Leistungsgewinn und dem akzeptablen Risikoniveau. Wenn eine Optimierung 80 % des Problems mit geringem Aufwand löst, hat sie Vorrang vor dem Upgrade. Wenn die Grenze strukturell ist, muss man einfach die Dimension ändern.
Fehler, die vermieden werden sollten
Die schlechten Praktiken sind oft dieselben: Symptom und Ursache verwechseln, mehrere Parameter gleichzeitig ändern, Logs ignorieren oder Dienste ohne echten Bedarf hinzufügen. Die Falle ist zu glauben, dass eine schnelle Aktion zwangsläufig eine gute Aktion ist. Das ist nicht immer so, ganz im Gegenteil.
- Nicht diagnostizieren bevor man korrigiert.
- Nicht systematisch neu starten, ohne die Ursache der Langsamkeit zu verstehen.
- Keine unnötigen Dienste vervielfachen, die CPU und RAM verbrauchen.
- Das Monitoring nach der Änderung nicht vernachlässigen.
- Keine Optimierung ohne Messung vor/nachher anwenden.
Zum Merken
🧭 Ein langsamer Server wird besser mit einer Methode behandelt als mit Vermutungen.
🔧 Die Priorität liegt auf dem tatsächlichen Engpass, nicht auf dem sichtbarsten Symptom.
📊 Die wichtigsten Metriken bleiben CPU, RAM, Festplatten-I/O und Server-Antwortzeit.
🗃️ Eine langsame Datenbank oder ein schlecht konfigurierter Server-Cache kann alles verlangsamen.
🚦 Das Server-Monitoring verhindert, dass derselbe Leistungsabfall erneut auftritt.
FAQ
Warum wird mein Server plötzlich langsam?
Eine plötzliche Verlangsamung deutet oft auf eine plötzliche Überlastung, ein problematisches Update, eine schwere geplante Aufgabe oder ein Datenbankproblem hin. Man muss die Logs, die Systemlast und die Verkehrsspitzen im genauen Zeitraum des Problems überprüfen. Ohne diese Korrelation navigiert man blind.
Wie erkennt man, ob das Problem von der CPU, dem RAM oder der Festplatte kommt?
Am einfachsten ist es zu beobachten, welcher Indikator zuerst ansteigt, wenn die Langsamkeit auftritt. Eine sehr hohe CPU verlangsamt die Berechnung, unzureichender RAM löst Swapping aus, und eine langsame Festplatte erkennt man an langer I/O-Wartezeit. Die drei können auch kombiniert auftreten.
Sollte man einen langsamen Server neu starten?
Nur wenn die Diagnose es rechtfertigt. Ein Neustart kann eine Überlastung vorübergehend lindern, behebt aber nicht die Ursache. Wenn du nicht weißt, warum der Server langsam wird, solltest du zuerst die Metriken und Logs sammeln und dann das eigentliche Problem angehen.
Kann der Cache einen Server wirklich beschleunigen?
Ja, oft erheblich. Ein guter Server-Cache vermeidet es, dieselben Daten immer wieder neu zu berechnen oder zu lesen, was die Last auf der Datenbank und dem Prozessor reduziert. Aber ein schlecht konfigurierter Cache kann auch Inkonsistenzen erzeugen oder ein anderes Problem verschleiern.
Wann sollte man die Server-Ressourcen erhöhen?
Wenn die Optimierungen bereits umgesetzt sind, aber die Überlastung ständig zurückkehrt. Wenn der Verkehr steigt und die Ressourcen trotz guter Abstimmung an ihre Grenzen stoßen, ist ein Upgrade rationaler als eine Reihe von Mikrokorrekturen. Wichtig ist, den erwarteten Gewinn vor der Entscheidung zu messen.