.en-bref { max-width: auto; margin: 2em auto; padding: 1.5em 1.8em; color: #78350f; font-family: „Inter“, „Segoe UI“, sans-serif; text-align: left; position: relative; box-sizing: border-box; background: #fff2d7; border: 0; border-left: 0px solid #b45309; border-radius: 0; box-shadow: none; }
.en-bref h2, .en-bref .en-bref-header { font-size: 1.15em; font-weight: 700; margin-bottom: 0.6em; color: #b45309; }
.en-bref p, .en-bref li { font-size: 1em; line-height: 1.65; margin: 10px; }
.en-bref strong { color: #451a03; }
.mg-callout{margin:1.5em 0;padding:.9em 1.1em;border:1px solid;border-left-width:4px;border-radius:10px;font-size:.97em;line-height:1.65}.mg-callout>:first-child{margin-top:0}.mg-callout>:last-child{margin-bottom:0}.mg-callout__label{display:block;margin:0 0 .35em;font-weight:700;font-size:.82em;letter-spacing:.03em;text-transform:uppercase}.mg-callout__label::before{margin-right:.45em;font-size:1.05em;vertical-align:-.06em}.mg-callout–info{background:#eff6ff;border-color:#bfdbfe;color:#1e3a5f}.mg-callout–info .mg-callout__label{color:#2563eb}.mg-callout–info .mg-callout__label::before{content:“\2139\FE0F“}.mg-callout–tip{background:#f0fdf4;border-color:#bbf7d0;color:#14532d}.mg-callout–tip .mg-callout__label{color:#15803d}.mg-callout–tip .mg-callout__label::before{content:“\1F4A1″}.mg-callout–warning{background:#fffbeb;border-color:#fde68a;color:#7a4a10}.mg-callout–warning .mg-callout__label{color:#b45309}.mg-callout–warning .mg-callout__label::before{content:“\26A0\FE0F“}.mg-callout–danger{background:#fef2f2;border-color:#fecaca;color:#7f1d1d}.mg-callout–danger .mg-callout__label{color:#dc2626}.mg-callout–danger .mg-callout__label::before{content:“\1F6D1″}.mg-proscons{display:grid;grid-template-columns:1fr 1fr;gap:16px;margin:1.5em 0}@media(max-width:560px){.mg-proscons{grid-template-columns:1fr}}.mg-proscons__col{padding:.9em 1.1em;border:1px solid;border-radius:10px}.mg-proscons__title{display:flex;align-items:center;gap:.4em;margin:0 0 .5em;font-weight:700;font-size:.9em;letter-spacing:.02em}.mg-proscons__col ul{margin:.3em 0 0;padding-left:1.15em}.mg-proscons__col li{margin:.3em 0;line-height:1.55}.mg-proscons__col–pro{background:#f0fdf4;border-color:#bbf7d0;color:#14532d}.mg-proscons__col–pro .mg-proscons__title{color:#15803d}.mg-proscons__col–pro .mg-proscons__title::before{content:“\2705″}.mg-proscons__col–con{background:#fef2f2;border-color:#fecaca;color:#7f1d1d}.mg-proscons__col–con .mg-proscons__title{color:#dc2626}.mg-proscons__col–con .mg-proscons__title::before{content:“\274C“}ol.mg-steps{list-style:none!important;counter-reset:mgstep;margin:1.6em 0;padding-left:0!important}ol.mg-steps>li.mg-steps__item{counter-increment:mgstep;list-style:none!important;padding-left:0!important;padding-bottom:1.4em}ol.mg-steps>li.mg-steps__item:last-child{padding-bottom:0}ol.mg-steps>li.mg-steps__item>:last-child{margin-bottom:0}ol.mg-steps>li.mg-steps__item>.mg-steps__title{margin:0 0 .25em;font-weight:600}ol.mg-steps>li.mg-steps__item>.mg-steps__title::before{content:counter(mgstep) „. „;opacity:.45;font-weight:500;font-variant-numeric:tabular-nums}ol.mg-steps>li.mg-steps__item:not(:has(.mg-steps__title))::before{content:counter(mgstep) „. „;opacity:.45;font-weight:500;font-variant-numeric:tabular-nums}.mg-kpis{display:grid;grid-template-columns:repeat(auto-fit,minmax(140px,1fr));gap:14px;margin:1.5em 0}.mg-kpi{padding:1em .9em;border:1px solid #e5e7eb;border-radius:12px;background:#f9fafb;text-align:center}.mg-kpi__value{display:block;font-size:1.7em;font-weight:800;line-height:1.15;color:#111827}.mg-kpi__label{display:block;margin-top:.35em;font-size:.85em;color:#6b7280;line-height:1.35}
.wp-block-image,.ai-image{margin-bottom:1.75em}.wp-block-image>figcaption,.ai-image>figcaption{margin-top:.5em}
.magic-lb-overlay{position:fixed;inset:0;background:rgba(15,23,42,.92);display:none;align-items:center;justify-content:center;z-index:99999;cursor:zoom-out;padding:20px}
.magic-lb-overlay.open{display:flex}
.magic-lb-overlay img{max-width:95vw;max-height:95vh;object-fit:contain;border-radius:8px;box-shadow:0 8px 32px rgba(0,0,0,.5)}
.magic-lb-close{position:absolute;top:16px;right:20px;color:#fff;background:rgba(0,0,0,.5);border:none;width:40px;height:40px;border-radius:50%;font-size:24px;cursor:pointer;display:flex;align-items:center;justify-content:center}
.magic-lb-close:hover{background:rgba(0,0,0,.8)}
.wp-block-image img{cursor:zoom-in;transition:transform .15s ease}
.wp-block-image img:hover{transform:scale(1.01)}
.magic-img-link{display:inline-block;text-decoration:none}
(function(){
var ov=document.getElementById(‚magic-lb‘);if(!ov)return;
var img=ov.querySelector(‚img‘),btn=ov.querySelector(‚.magic-lb-close‘);
function open(src){img.src=src;ov.classList.add(‚open‘);document.body.style.overflow=’hidden‘}
function close(){ov.classList.remove(‚open‘);img.src=“;document.body.style.overflow=“}
document.addEventListener(‚click‘,function(e){
var a=e.target.closest(‚a.magic-img-link‘);
if(a){e.preventDefault();open(a.getAttribute(‚href‘));return}
var i=e.target.closest(‚.wp-block-image img‘);
if(i&&!e.target.closest(‚a‘)){e.preventDefault();open(i.currentSrc||i.src)}
});
ov.addEventListener(‚click‘,function(e){if(e.target===ov||e.target===btn)close()});
document.addEventListener(‚keydown‘,function(e){if(e.key===’Escape‘)close()});
})();
Google durchsucht eine Seite, ohne sie zu indexieren, wenn Googlebot ihre URL besucht hat, sie aber nicht in seinen Index aufgenommen wurde. Dieser Status signalisiert nicht automatisch eine Strafe. Zuerst muss überprüft werden, ob die Seite tatsächlich in Google erscheinen soll, dann sollten Inhalt, kanonische URL, technische Anweisungen, interne Verlinkung und Zugänglichkeit kontrolliert werden.
Eine Seite kann technisch zugänglich sein und dennoch als zu ähnlich zu einer anderen URL, wenig nützlich oder nicht prioritär genug eingestuft werden. Das Adressinspektionstool der Google Search Console ermöglicht es, diese Fälle zu unterscheiden, aber eine Indexierungsanfrage garantiert niemals die Aufnahme der Seite in die Ergebnisse.
Kurz gesagt
- 🔎 „Durchsucht, derzeit nicht indexiert“ bedeutet, dass Google die URL besucht hat, sie aber nicht in seinem Index behalten hat.
- 🧭 Überprüfen Sie zuerst das Ziel der Seite, dann die kanonische URL, das noindex-Tag, die robots.txt-Datei, den HTTP-Code und den Inhalt.
- 🧩 Eine nützliche Seite muss eindeutig, zugänglich, durch interne Links verbunden und mit dem XML-Sitemap-Plan konsistent sein.
- ⏳ Die Google-Indexierungsanfrage löst eine erneute Crawling-Anfrage aus. Sie ist kein Versprechen für Indexierung oder Ranking.
Durchsuchte Seite, derzeit nicht indexiert: Was dieser Status wirklich bedeutet
Der Status zeigt einen Besuch von Googlebot an, keine redaktionelle Freigabe. Google konnte die URL abrufen und ihren Inhalt analysieren, aber die URL wurde zum Zeitpunkt der Prüfung nicht zum Index hinzugefügt. Crawling und Indexierung sind zwei unterschiedliche Entscheidungen.
Google hat die Seite besucht, aber nicht unbedingt aufgenommen
Die Erkennung entspricht dem Moment, in dem Google eine URL kennt, zum Beispiel durch einen Link oder eine XML-Sitemap. Das Crawling erfolgt, wenn Googlebot die Seite vom Server anfordert. Die Indexierung ist dann die Auswahl dieser Seite in der Ergebnisdatenbank. Das Ranking folgt noch später: Eine indexierte Seite kann für eine bestimmte Suchanfrage sehr schwer zu finden sein.
Die Meldung „Durchsuchte Seite, derzeit nicht indexiert“ liefert allein keine genaue Ursache. Sie kann eine zugängliche Seite mit redundantem Inhalt, einer anderen kanonischen URL, geringer interner Priorität oder einem nicht ausreichend unterscheidbaren redaktionellen Wert begleiten. Die Dokumentation von Google Search Central beschreibt die Indexierung als einen nicht garantierten Prozess, auch nach dem Crawling.
Eine nicht indexierte Seite ist nicht unbedingt ein Problem
Eine URL für Filter, Sortierung, interne Suche, Tests oder privaten Bereich ist in der Regel nicht dazu bestimmt, einen Besuch von Google anzuziehen. Ein zurückgezogenes Produktblatt, eine fast identische Variante oder eine temporäre Seite kann ebenfalls bewusst ausgeschlossen werden. Die erste Entscheidung besteht daher darin, diese Frage klar zu beantworten: Dient die URL einer identifizierbaren Suche und einem echten Ziel der Website?
Der Glaube „jede veröffentlichte Seite muss indexiert werden“ ist falsch. Eine konsistente Website kann zugängliche, aber ausgeschlossene URLs enthalten, während eine strategische Seite eher eine gründliche Korrektur als eine einfache erneute Anfrage in der Search Console verdient.
Diagnose der URL vor jeder Korrektur
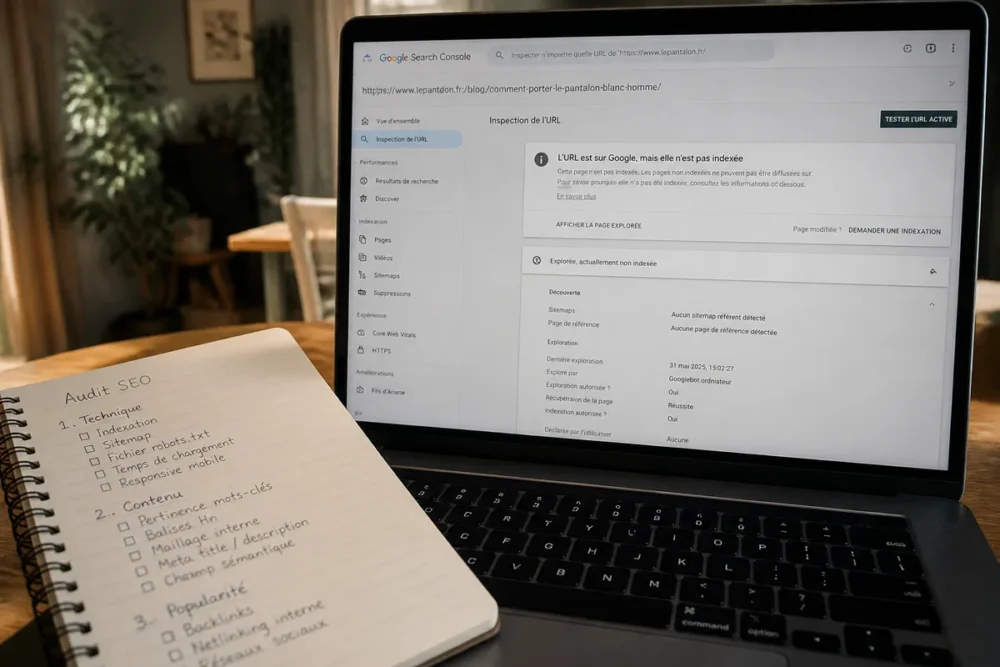
Beginnen Sie mit der genauen Adresse: Protokoll, Subdomain, Parameter und abschließender Schrägstrich können unterschiedliche URLs bezeichnen. Das Adressinspektionstool der Google Search Console vergleicht den bekannten Status der URL mit dem Ergebnis eines Tests der aktuell zugänglichen Version.
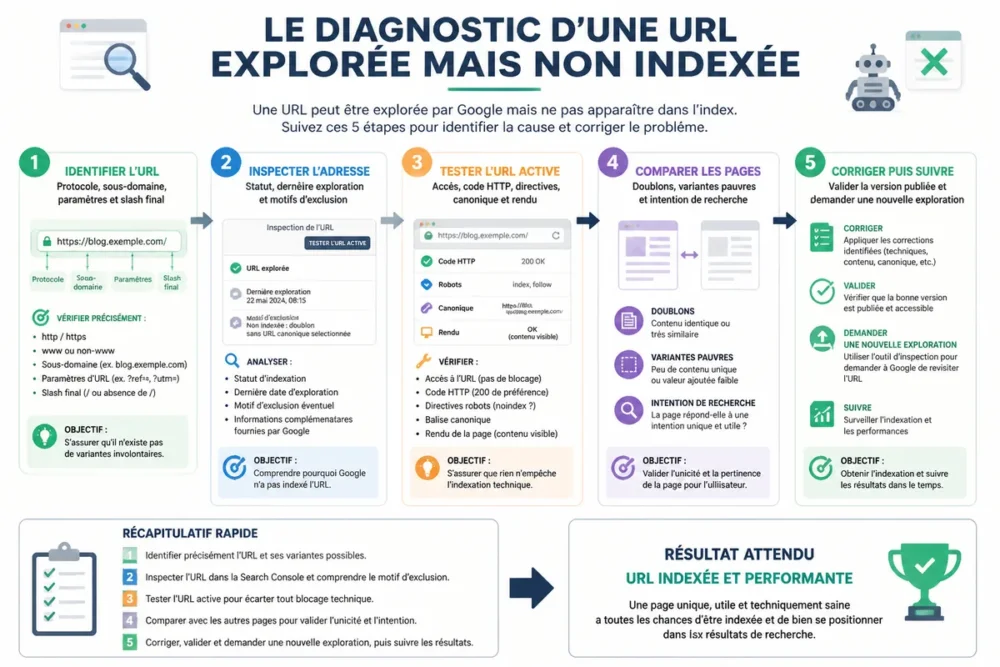
Nützliche Informationen im Adressinspektionstool lesen
Untersuchen Sie die problematische URL in der Search Console und notieren Sie den Abdeckungsstatus, das Datum der letzten Erfassung, die deklarierte kanonische URL und die von Google ausgewählte kanonische URL, wenn diese angezeigt wird. Vergleichen Sie auch die Ergebnisse des Tests der aktiven URL mit der bereits von Google bekannten Version.
Eine Abweichung zwischen der deklarierten kanonischen URL und der von Google ausgewählten kanonischen URL ist ein wichtiges Signal, aber kein automatischer Beweis für eine Fehlkonfiguration. Die von Google gewählte Seite kann als repräsentativere Version angesehen werden, wenn mehrere URLs denselben Bedarf erfüllen.
Grundlegende technische Signale überprüfen
Überprüfen Sie den endgültigen HTTP-Code. Eine für die Indexierung vorgesehene Seite sollte normalerweise öffentlich zugänglich sein und eine stabile Antwort ohne Weiterleitungsschleifen oder anhaltende Serverfehler zurückgeben. Prüfen Sie anschließend das Meta-Robots-Tag, den HTTP-Header X-Robots-Tag, das kanonische Tag, die robots.txt-Regeln und das Vorhandensein der endgültigen URL in der XML-Sitemap.
Die robots.txt-Datei verdient besondere Aufmerksamkeit: Sie kann das Crawlen einer Ressource verhindern, ersetzt jedoch keine noindex-Direktive. Eine URL, die für das Crawlen blockiert ist, kann daher Google bekannt bleiben, ohne dass ihr Inhalt korrekt bewertet werden kann.
Die Seite aus Sicht einer Suchmaschine und eines Lesers bewerten
Öffnen Sie die Seite ohne angemeldete Sitzung und überprüfen Sie, ob der Hauptinhalt tatsächlich angezeigt wird. Eine unvollständige JavaScript-Darstellung, ein Ladefehler oder Inhalte, die erst nach einer Interaktion sichtbar sind, können das Verständnis der URL beeinträchtigen.
Vergleichen Sie die Seite mit ähnlichen URLs der Website: ähnliche Produktseiten, lokale Seiten, Kategorien, Artikel mit derselben Intention oder Varianten mit Parametern. Eine ältere Seite kann auch aus dem Index verschwinden, wenn ihr Inhalt veraltet ist, eine andere URL sie ersetzt oder ihr relativer Wert nach einer Überarbeitung sinkt.
-
Exakte Adresse notieren
Kopieren Sie die URL so, wie sie veröffentlicht ist, und notieren Sie eventuelle Parameter.
-
In der Search Console inspizieren
Vergleichen Sie den bekannten Status, die kanonische URL und das Erfassungsdatum mit dem Test der aktiven URL.
-
Indexierbarkeit prüfen
Überprüfen Sie den HTTP-Code, Weiterleitungen, noindex, X-Robots-Tag, robots.txt und die Darstellung.
-
Inhalte vergleichen
Identifizieren Sie Duplikate, schwache Varianten und Seiten, die bereits dieselbe Intention ansprechen.
-
Korrigieren und dann überwachen
Fordern Sie eine erneute Erfassung erst nach Validierung der veröffentlichten Version an.
Die häufigsten Ursachen für eine gecrawlte, aber nicht indexierte Seite
Eine gecrawlte, aber nicht indexierte Seite hat keine einzelne Ursache. Die Diagnose muss freiwillige Ausschlüsse, technische Widersprüche, Duplikate und geringe redaktionelle Priorität trennen, um eine unangemessene Korrektur zu vermeiden.
| Beobachtetes Symptom | Überprüfung | Geeignete Maßnahme | Zu vermeidender Fehler |
|---|---|---|---|
| noindex-Direktive | Quellcode und HTTP-Header | Die Direktive entfernen, wenn die Seite indexiert werden soll | Sie entfernen, ohne die Rolle der URL zu prüfen |
| Unterschiedliche kanonische URL | Kanonisches Tag und ausgewählte URL | Die kanonische URL an die Referenzseite anpassen | Eine kanonische URL deklarieren, die dem internen Linkaufbau widerspricht |
| Sehr ähnlicher Inhalt | Vergleich mit benachbarten Seiten | URLs differenzieren, zusammenführen oder hierarchisieren | Generischen Text ohne neuen Wert hinzufügen |
| Verwaiste Seite | Interne Links und Navigationspfad | Kontextuelle Links von relevanten Seiten erstellen | Künstlich irrelevante Links erstellen |
| Instabiler Zugriff oder Darstellung | HTTP-Code, Server und Test der aktiven URL | Zugriff und Laden des Hauptinhalts korrigieren | Indexierung erneut anstoßen, bevor die Seite stabil ist |
Eine Anweisung oder eine Konfiguration schließt die URL aus
Ein Noindex-Tag kann von einer Vorlage, einer Einstellung im Content-Management-System oder einem SEO-Tool stammen. Ein Canonical, das auf eine andere Seite zeigt, eine falsch konfigurierte Weiterleitung, ein Serverfehler oder eine Zugriffsregel können ebenfalls die Behandlung der URL beeinflussen.
Die XML-Sitemap hebt keine dieser Anweisungen auf. Eine Sitemap hilft Google, die URLs zu kennen, die die Website als wichtig erachtet, erzwingt jedoch weder das Crawlen noch die Indexierung.
Google bevorzugt eine sehr ähnliche andere Seite
Duplikate sind nicht auf exakte Kopien beschränkt. Zwei Einträge mit fast identischer Beschreibung, lokale Seiten, die sich nur durch einen Stadtnamen unterscheiden, oder Filter-URLs können denselben Bedarf mit zu wenig nützlichem Unterschied abdecken. Google kann dann eine andere Version als Referenz wählen.
Die Entscheidung sollte redaktionell und nicht nur technisch getroffen werden: Behalten Sie zwei Seiten, wenn sich deren Zielgruppen, Informationen und Absichten tatsächlich unterscheiden; führen Sie sie zusammen, wenn ihre Koexistenz dieselbe Antwort zerstreut. Eine Weiterleitung sollte erst nach Überprüfung des Werts der alten URL für Nutzer und bestehende Links eingerichtet werden.
Die Seite fehlt an redaktionellem Wert oder Prioritätssignalen
Eine kurze Seite ist nicht automatisch schlecht. Das Problem entsteht, wenn sie unvollständig, austauschbar oder weniger präzise antwortet als eine andere bereits vorhandene Seite auf der Website. Eine strategische Seite muss eine erkennbare Antwort, überprüfbare Informationen, einen eigenen Blickwinkel und ein ausreichendes Leseerlebnis für ihre Absicht bieten.
Eine verwaiste Seite, die selten verlinkt oder in einem schwer zugänglichen Bereich veröffentlicht wird, erhält ebenfalls weniger interne Prioritätssignale. Externe Links können bei der Entdeckung und Glaubwürdigkeit helfen, aber ihr Fehlen beweist allein nicht die Ursache für die Nicht-Indexierung.
Korrigieren je nach Ursache, ohne die Indexierung erzwingen zu wollen
Die richtige Korrektur ist die, die den erkannten Widerspruch beseitigt. Das Entfernen eines Noindex-Tags, das Umschreiben einer Seite oder das Hinzufügen eines internen Links ohne Diagnose kann das Problem verschieben statt lösen. Eine strategische URL muss nützlich, indexierbar, kanonisch und mit der Website verbunden sein.
Ein unbeabsichtigtes technisches Blockieren beheben
Entfernen Sie die Noindex-Anweisung nur, wenn die URL in Suchmaschinen sichtbar sein soll. Stimmen Sie dann das Canonical-Tag, die internen Links, die XML-Sitemap und Weiterleitungen auf dieselbe finale URL ab. Überprüfen Sie den Quellcode und den aktiven URL-Test nach der Veröffentlichung.
Ein Zugriffsfehler muss server- oder anwendungsseitig behoben werden. Der Hauptinhalt muss ohne Anmeldung und ohne instabiles Laden abrufbar sein. Eine Indexierungsanfrage vor dieser Validierung bietet keine dauerhafte Lösung.
Eine nützliche, aber unzureichend unterscheidbare Seite stärken
Schreiben Sie um die tatsächliche Absicht herum neu, statt den Text mechanisch zu verlängern. Fügen Sie fehlende Informationen hinzu: Verfahren, Kriterien, Grenzen, Beispiele, datierte Daten oder benannte Quellen. Expertise-Elemente müssen überprüfbar sein; eine Seite gewinnt nicht an Zuverlässigkeit durch das Hinzufügen werblicher Formulierungen.
Für eine redaktionelle Website kann die Analyse einer bereits indexierten Seite diese Kontrolle ergänzen, vorausgesetzt, es werden URLs mit ähnlicher Absicht verglichen. Für eine kommerzielle oder lokale Seite unterscheiden Sie die tatsächlich zum Angebot gehörenden Daten, anstatt nur einige Schlüsselwörter auszutauschen.
Die interne Verlinkung verbessern und Duplikate behandeln
Fügen Sie kontextuelle interne Links von wichtigen und relevanten Seiten hinzu: eine Kategorie zu einem Eintrag, ein Artikel zu einer detaillierten Methode oder eine Serviceseite zu einem tatsächlich abgedeckten Gebiet. Der Ankertext muss das Ziel beschreiben und der Link soll den Nutzerfluss unterstützen, nicht nur ein Signal übertragen.
Entfernen Sie weitergeleitete, ausgeschlossene oder nicht kanonische URLs aus der Sitemap. Behalten Sie die finale URL, die die Website gecrawlt sehen möchte. Wenn zwei Seiten denselben Bedarf abdecken, kann das Zusammenführen sauberer sein als das Beibehalten von zwei schwachen Inhalten.
Eine erneute Erkundung anfordern und die Entwicklung verfolgen
Die Google-Indexierungsanfrage ist nach einer bedeutenden Korrektur an einer finalen, zugänglichen und tatsächlich nützlichen URL gerechtfertigt. Die Funktion kann sich in der Search Console weiterentwickeln; überprüfen Sie die Formulierungen und angezeigten Grenzen in der Oberfläche zum Zeitpunkt der Nutzung.
Wann die Google-Indexierungsanfrage verwenden
Verwenden Sie sie nach der Korrektur eines noindex, eines Canonical-Tags, eines Zugriffsproblems oder einer wesentlichen redaktionellen Überarbeitung. Die Anfrage sendet eine Aufforderung an Google, die URL erneut zu crawlen; sie reserviert keinen Platz im Index und garantiert keine Indexierungszeit von Google.
Wiederholen Sie dieselbe Anfrage nicht in einer Schleife. In diesem Fall fordern Sie keine Indexierung an, bevor die Ursache behoben ist. Eine doppelte Seite oder eine Seite ohne eigene Absicht bleibt inhaltlich zu bearbeiten.
Wann warten, verbessern oder das Ziel der Seite überdenken
Nach einer Änderung geben Sie Google Zeit, die Seite erneut zu besuchen und die Signale neu zu bewerten. Es gibt keine universelle Frist, die ohne Kenntnis der Website, ihrer Architektur, der Crawl-Frequenz und der Bedeutung der URL angegeben werden kann.
Verfolgen Sie den Status in der Search Console und vergleichen Sie das Datum der letzten Erkundung. Wenn die URL sekundär bleibt, einer anderen ähnlich ist oder für eine identifizierbare Suche nutzlos ist, verbessern Sie sie, fassen Sie sie zusammen, leiten Sie sie weiter oder schließen Sie sie je nach Rolle aus. Das Ziel ist ein kohärenter Index, nicht ein maximales URL-Volumen.
Eine einfache Nachverfolgungsmethode
Bewahren Sie für jede URL das Datum der Korrektur, die Art der Änderung und das beobachtete Ergebnis auf. Diese Aufzeichnung verhindert, mehrere Signale gleichzeitig zu ändern, ohne zu wissen, was sich geändert hat. Ein Log-Audit kann die Search Console bei einer wichtigen Website ergänzen, insbesondere um die Googlebot-Durchläufe und Serverantworten zu überprüfen, ersetzt aber keine Inhaltsanalyse.
SEO-Tools oder WordPress-Erweiterungen können die Kontrolle von Tags, Sitemap und Links erleichtern. Sie verfügen jedoch nicht über ein legitimes Mittel, um die Indexierung zu garantieren; ihre Warnungen müssen auf der veröffentlichten Seite und in der offiziellen Google-Dokumentation bestätigt werden.
Häufige Fragen zu Google, das crawlt, aber nicht indexiert
Wird eine gecrawlte, aber nicht indexierte Seite von Google bestraft?
Nein, dieser Status beweist keine Strafe. Er zeigt an, dass Google die URL gecrawlt, sie aber zu diesem Zeitpunkt nicht in seinen Index aufgenommen hat. Suchen Sie zuerst nach einer technischen Anweisung, einem Duplikat oder einem redaktionell nicht ausreichend unterscheidbaren Wert.
Reicht eine XML-Sitemap aus, um eine Seite zu indexieren?
Nein. Eine XML-Sitemap signalisiert die URLs, die die Website für wichtig hält, garantiert aber weder das Crawlen noch die Indexierung. Die URL muss auch zugänglich, kohärent mit ihrem Canonical, nützlich und richtig mit dem Rest der Website verlinkt sein.
Wie lange sollte man nach einer Google-Indexierungsanfrage warten?
Google gibt keine universelle Frist an, die für alle Seiten gilt. Überwachen Sie die letzte Erkundung und den Status in der Search Console, anstatt die Anfragen zu vervielfachen. Ein fehlendes Ergebnis sollte dazu führen, die Seite erneut zu prüfen, nicht nur das Tool erneut zu starten.
Sollte man eine Seite löschen, die Google nicht indexiert?
Nein, nicht automatisch. Bewahren und verbessern Sie eine Seite, die eine eigene Absicht verfolgt; fassen Sie sie zusammen, wenn eine andere URL denselben Bedarf erfüllt; schließen Sie sie aus, wenn sie einem Filter, einem Test oder einer Funktion dient, die nicht in Google erscheinen soll.
Warum kann eine alte Seite aus dem Google-Index verschwinden?
Eine alte Seite kann weniger nützlich werden, durch eine andere URL ersetzt werden, ihre technische Kohärenz verlieren oder nicht mehr korrekt auf die Suchintention antworten. Prüfen Sie Inhaltsänderungen, Canonical-Tags, interne Links, Weiterleitungen und Zugänglichkeit, bevor Sie eine Schlussfolgerung ziehen.
Kann man mehrmals die Indexierung derselben URL anfragen?
Eine neue Anfrage kann nach einer substantiellen Korrektur gestellt werden, aber identische Wiederholungen sind keine Strategie. Beheben Sie zuerst das identifizierte Problem, validieren Sie die veröffentlichte Version und verwenden Sie die Anfrage für eine final wirklich nützliche URL.
Eine dauerhafte Indexierung wird gefördert, indem technische Widersprüche beseitigt und jeder URL ein klarer, einzigartiger und gut mit dem Rest der Website verbundener Nutzen gegeben wird. Wenn die Diagnose keine Entscheidung zulässt, bewahren Sie die Beobachtungen aus der Search Console, die Serverantworten und die Inhaltsversionen vor weiteren Änderungen auf.