Pour trouver les pages orphelines, comparez les URL connues grâce au sitemap, à Google Search Console et aux données de fréquentation avec les pages atteignables par des liens internes. Vérifiez ensuite chaque écart manuellement, puis reliez, mettez à jour, redirigez ou supprimez la page selon sa valeur réelle.
Une page peut rester indexée, recevoir des visites ou figurer dans un sitemap sans être reliée au reste du site. Un simple audit gratuit doit donc distinguer l’absence de lien interne, la non-indexation, l’inaccessibilité et la faible audience avant toute correction.
En bref
🔎 Une page orpheline ne reçoit aucun lien interne entrant depuis les pages accessibles du site.
📄 Le sitemap ne suffit pas : il faut croiser ses URL avec la navigation, les contenus, Search Console et les données d’audience disponibles.
🧭 Une URL détectée est une candidate, pas une preuve : la confirmation exige une vérification manuelle des chemins d’accès internes.
🛠️ La bonne correction dépend de la valeur de la page : relier une page utile, rediriger une page équivalente ou supprimer un contenu sans intérêt.
Page orpheline : la reconnaître sans faux diagnostic
Une page orpheline est une URL existante qui ne reçoit aucun lien interne entrant depuis les autres pages accessibles du site. Elle peut pourtant être connue par son adresse directe, un lien externe, un sitemap XML ou un moteur de recherche. Le diagnostic porte donc sur le maillage interne, pas sur le trafic ou l’indexation.
Une page orpheline est une page publiée sans chemin interne pertinent vers elle. Sur un petit site, cet isolement complique la navigation, la maintenance des contenus et la découverte des pages par les utilisateurs comme par les robots d’exploration. L’impact sur le référencement n’est pas automatique : il dépend notamment de l’indexation, des liens externes et de l’architecture générale.
Une page non indexée n’apparaît pas nécessairement dans les résultats de Google, mais elle peut recevoir des liens internes. Une page peu visitée possède parfois un maillage correct. Une page inaccessible renvoie une erreur, exige une connexion ou bloque l’accès. Une page volontairement isolée, comme une landing page de campagne publicitaire, peut remplir son rôle sans lien de navigation classique.
Ce qu’un lien interne doit permettre de vérifier
Une page correctement intégrée doit être atteignable depuis au moins un chemin éditorial ou fonctionnel du site : article, page de catégorie, menu, fil d’Ariane, pied de page ou bloc de contenus associés. Un lien contextuel placé dans une page proche du sujet est préférable à une accumulation artificielle dans le menu principal.
Le texte d’ancrage doit décrire clairement la page ciblée. Un lien intitulé « en savoir plus » apporte moins d’information qu’une ancre comme « vérifier les pages non liées », à condition que la page de destination traite réellement ce sujet.
Préparer l’inventaire gratuit des URL à comparer
Un tableur centralise les URL connues et permet de documenter chaque décision. Rassemblez les adresses visibles dans la navigation, les catégories, les archives, le sitemap XML, Google Search Console et l’outil d’audience utilisé par le site. Cette liste constitue un inventaire de travail, pas une vérité automatique.
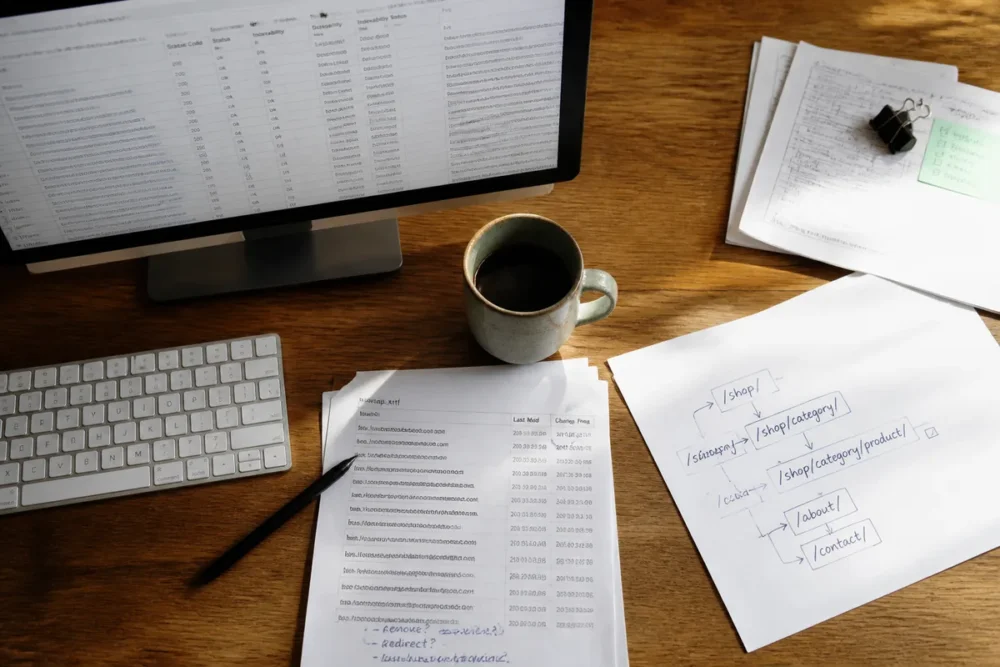
Avant la comparaison, nettoyez les données. Regroupez les doublons, signalez les redirections, écartez les pages supprimées et séparez les fichiers, paramètres d’URL et variantes techniques des véritables pages de contenu. Une URL redirigée n’est pas une page active à relier comme les autres.
Les colonnes utiles dans le tableur
Chaque ligne doit permettre de comprendre pourquoi une URL a été retenue, ce qui a été vérifié et quelle action a été décidée. Ajoutez une date de contrôle afin de distinguer une observation actuelle d’un ancien constat.
| Colonne | Utilité | Décision ou vigilance |
|---|---|---|
| URL | Identifier précisément la page contrôlée | Conserver l’URL canonique |
| Source de découverte | Indiquer navigation, sitemap, Search Console ou audience | Croiser plusieurs sources |
| Statut HTTP | Vérifier que l’adresse répond réellement | Écarter erreur et redirection avant classement |
| Lien interne trouvé | Noter la page qui pointe vers l’URL | Indiquer « aucun identifié » seulement après contrôle |
| Visites récentes | Mesurer l’usage connu de la page | Le trafic ne prouve pas un lien interne |
| Décision et date | Garder un historique de traitement | Relier, mettre à jour, rediriger, supprimer ou ne rien faire |
Les sources à croiser sur un petit site
Commencez par les menus, catégories, archives, pages piliers et contenus connexes. Ajoutez les URL du fichier sitemap.xml lorsqu’il existe, puis consultez les rapports disponibles dans Google Search Console. Un outil de mesure d’audience peut révéler des pages encore consultées, mais aucune de ces sources ne fournit seule une liste exhaustive des pages orphelines.
Détecter les candidates avec trois sources gratuites
La méthode gratuite repose sur un écart : une URL est connue par une source, mais aucun parcours interne ne permet de l’atteindre. Traitez cet écart comme une candidate à vérifier. Un crawl limité aux liens internes ne peut pas découvrir une page qui n’est justement reliée à aucune autre.
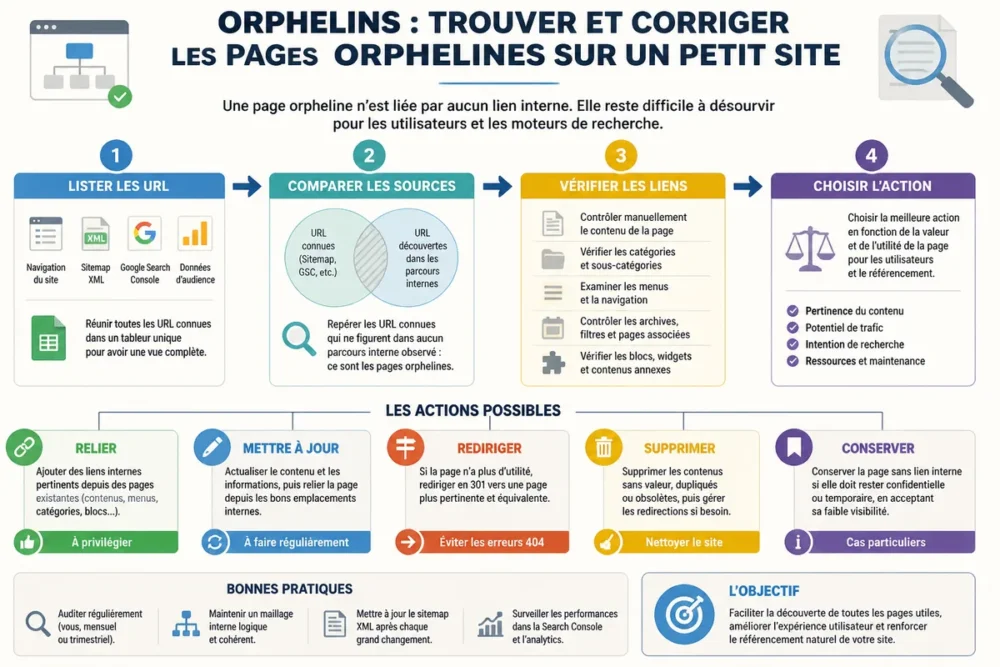
Étape 1 : Relever le sitemap et les URL connues
Copiez les adresses du sitemap XML dans le tableur. Complétez-les avec les URL rencontrées dans les menus, les catégories, les pages de contenu et les rapports accessibles de Google Search Console. Ajoutez les anciennes pages consultées repérées dans l’outil d’audience.
Une URL présente dans le sitemap mais absente des parcours visibles mérite un contrôle. Elle n’est pas automatiquement orpheline : le lien peut se trouver dans une archive, un pied de page ou une page que vous n’avez pas encore examinée.
Étape 2 : Comparer la navigation et les contenus
Parcourez les pages structurantes du site. Notez dans la colonne « lien interne trouvé » chaque page qui renvoie vers une URL de l’inventaire. Les pages proches du sujet sont prioritaires : une page service peut pointer vers une page d’explication, et un article peut renvoyer vers une page pilier.
Pour chaque URL candidate, inscrivez dans la colonne « Lien interne trouvé » les URL sources contrôlées et le résultat. Ne notez « aucun identifié » qu’après avoir vérifié les contenus connexes, catégories, archives, menus, fil d’Ariane, pied de page et blocs de recommandations applicables à cette URL.
Pour un volume réduit, travaillez par lots cohérents, par exemple les pages d’un même répertoire ou d’une même catégorie. Cette organisation limite les oublis et rend la preuve du contrôle lisible dans le tableur.
Étape 3 : Contrôler Search Console et la recherche sur le domaine
Consultez les rapports de Google Search Console pour repérer les URL connues, indexées ou exclues. Une URL indexée sans lien interne connu est une candidate intéressante, mais l’indexation prouve seulement que Google connaît l’adresse, pas qu’un maillage interne existe.
Une recherche limitée au domaine peut fournir des pistes supplémentaires. Elle ne constitue pas un inventaire complet : les résultats dépendent de l’indexation et de l’affichage du moteur. Vérifiez donc chaque adresse directement dans le site et dans le tableur.
Étape 4 : Exploiter les pages vues et leurs sources de trafic
Repérez les anciennes pages encore consultées alors qu’elles ne figurent plus dans la navigation actuelle. Examinez l’origine des visites : moteur de recherche, favori, lien externe ou lien interne. Une visite issue d’un favori ou d’un backlink confirme que la page est utilisée, mais ne crée aucun lien interne.
Confirmer manuellement qu’une page ne reçoit aucun lien interne
La confirmation manuelle commence par l’état réel de l’URL, puis examine tous les chemins internes plausibles. Ouvrez la page, contrôlez sa réponse, recherchez les liens entrants dans les contenus et consignez la preuve. Cette méthode convient aux petits volumes, mais elle est moins automatisée qu’un crawl spécialisé.
Une URL absente du menu n’est pas forcément orpheline. Un article connexe, une archive utile, un fil d’Ariane ou un bloc de recommandations peut encore fournir un lien entrant. La classification n’est fiable qu’après examen de ces emplacements.
Contrôler l’état réel de l’URL
Ouvrez chaque candidate et écartez les adresses qui redirigent, renvoient une erreur, demandent une authentification ou ne correspondent plus à une page active. Vérifiez aussi que l’adresse contrôlée est la version canonique utilisée par le site et non une variante technique.
Une page protégée par une connexion, une page de confirmation ou une URL réservée à un usage interne ne se traite pas comme un contenu éditorial public. Notez sa fonction dans le tableur avant de décider.
Rechercher les chemins d’accès internes oubliés
Examinez les articles connexes, pages de catégorie, archives, pages de tags utiles, menus secondaires, pied de page et blocs de contenus associés. La recherche interne du site peut aussi retrouver des mentions du sujet ou de l’URL.
Classez la page comme orpheline seulement lorsqu’aucun accès interne pertinent et fonctionnel n’est identifié. Un lien externe, une URL directe ou une présence dans le sitemap ne remplace pas cette vérification.
Corriger chaque page orpheline selon sa valeur réelle
La correction dépend de l’utilité actuelle, de la qualité du contenu, des visites, des backlinks, des campagnes en cours et de l’existence d’une page équivalente. Une page utile doit être réintégrée dans le maillage. Une page sans valeur identifiable peut être supprimée, mais seulement après contrôle de ses dépendances.
Dans ce cas, ne supprimez pas la page avant d’avoir vérifié ses visites et ses liens externes.
| Situation observée | Action prioritaire | Contrôle nécessaire |
|---|---|---|
| Contenu utile et à jour | Ajouter un lien contextuel | Ancre descriptive et page source pertinente |
| Contenu utile mais ancien | Mettre à jour puis relier | Informations, liens et renvois récents |
| Contenu faible doublonné | Fusionner si une destination cohérente existe | Conserver l’information utile et traiter l’ancienne URL |
| Page obsolète avec équivalent | Redirection permanente | Destination réellement équivalente |
| Page de test sans valeur | Supprimer | Visites, backlinks et liens internes à corriger |
| Landing page de campagne active | Ne rien faire par principe | Vérifier la campagne et son objectif |
Relier et mettre à jour une page qui reste utile
Ajoutez un lien depuis une page proche, une catégorie ou une page pilier. Le lien doit répondre à un besoin de lecture réel et employer une ancre cohérente avec le contenu de destination. Un ajout contextuel vaut mieux qu’un lien artificiel placé dans toutes les navigations.
Mettez à jour les informations périmées, les liens sortants et les renvois vers les contenus récents. Un lien interne ne corrige pas une page devenue inexacte ou inutile pour le lecteur.
Rediriger ou supprimer une page devenue inutile
Une redirection permanente convient lorsqu’une page réellement équivalente ou plus utile existe. La redirection ne doit pas envoyer automatiquement vers l’accueil ou vers une page sans rapport. Si aucune destination pertinente n’existe et que le contenu n’a aucune valeur utilisateur identifiable, la suppression peut être envisagée.
Avant toute suppression, vérifiez les visites, les backlinks éventuels, les campagnes encore actives et les liens internes qui pointent vers l’URL. Corrigez ces dépendances après l’intervention.
Vérifier les corrections et installer une routine légère
Le contrôle final consiste à rouvrir les pages conservées, tester les liens ajoutés, suivre les redirections et retirer les URL supprimées des liens internes. Mettez à jour le sitemap lorsque sa gestion l’exige. Conservez le tableur : il devient l’historique des décisions et des vérifications.
La fréquence dépend du rythme de publication et des changements de structure. Un audit après une refonte, une migration ou une modification importante de l’arborescence est prioritaire ; aucun seuil universel ne convient à tous les petits sites.
Le contrôle final page par page
- Ouvrez chaque page conservée et testez au moins un chemin interne pertinent.
- Vérifiez que le lien ajouté mène à la bonne URL canonique et utilise une ancre descriptive.
- Testez chaque redirection et confirmez que sa destination répond correctement.
- Retirez les liens internes qui menaient vers les pages supprimées ou redirigées.
- Ajoutez les nouvelles pages à une catégorie, une page pilier ou un contenu connexe adapté.
- Notez la date, le résultat et la prochaine vérification dans le tableur.
Si une correction importante vient d’être effectuée, Google Search Console peut servir à demander un nouveau contrôle de l’URL. Cette action ne garantit ni une indexation ni un changement de classement ; elle ferme simplement la boucle de vérification technique.
Questions fréquentes sur les pages orphelines
Les pages orphelines ne produisent pas toutes le même diagnostic. Une URL peut être indexée, visitée ou volontairement isolée tout en restant dépourvue de lien interne. Les réponses suivantes servent à interpréter les résultats avant de modifier l’arborescence.
Une page orpheline peut-elle être indexée par Google ?
Oui. Une page orpheline peut rester indexée si Google la connaît par un sitemap, un lien externe ou une autre source. L’absence de lien interne rend sa découverte et son intégration au site plus difficiles, sans empêcher absolument l’indexation.
Le sitemap suffit-il pour trouver toutes les pages orphelines ?
Non. Le sitemap indique des URL déclarées, mais ne montre pas les liens internes entrants. Comparez-le avec la navigation, les contenus, Search Console et les données d’audience, puis vérifiez chaque candidate manuellement.
Une page sans trafic est-elle forcément orpheline ?
Non. Une page peut recevoir des liens internes tout en ayant peu ou pas de visites mesurées. Le trafic renseigne sur l’usage connu de l’URL, tandis que le statut orphelin concerne uniquement l’absence de lien interne entrant.
Faut-il supprimer toutes les pages orphelines ?
Non. Reliez une page utile, mettez à jour un contenu ancien et redirigez une URL obsolète vers une destination réellement équivalente. Supprimez seulement une page sans valeur identifiable après vérification des visites, backlinks, campagnes et dépendances.
Combien de temps faut-il pour auditer un petit site ?
Aucun temps standard ne peut être annoncé sans connaître le nombre d’URL, la qualité du sitemap et la complexité de la navigation. Un petit inventaire bien tenu permet toutefois de traiter l’audit par lots limités plutôt que de contrôler tout le site en une seule fois.
La méthode fiable consiste à recenser les URL, croiser plusieurs sources, confirmer manuellement l’absence de lien interne puis choisir une correction proportionnée à la valeur de chaque page. Pour commencer, créez le tableur, exportez le sitemap et contrôlez les premières candidates une par une.
Sources utiles à consulter
- Documentation Google Search Central sur les sitemaps : vérifiez le rôle d’un sitemap dans la déclaration des URL et ses limites pour l’exploration et l’indexation.
- Documentation Google Search Central sur les liens explorables : vérifiez les caractéristiques des liens que Google peut explorer et utiliser pour découvrir les pages.
- Google Search Console : URL indexées ou exclues et inspection individuelle ; vérifiez les données dans l’interface actuelle.
- Outil de mesure d’audience : pages consultées et sources de trafic ; le trafic ne prouve pas l’existence d’un lien interne.